INOVM0028 · Team F3 “No Bad Ideas” · Case: VEED

六周,我们
找对了问题

我们原以为 VEED 用户嫌剪辑太慢。
问完才发现,真正卡住他们的是反馈太散、审批太乱。

以白板为准 · 旧版只作参考 访谈是 AI 模拟的 · Custom GPT 角色 分工暂不写 · 只写全组成果
先看简洁版:一问一答走一遍 →
W2 · 教室白板
W2 · seminar 现场
W5 · Maya Chen persona
W4 · 三个假设

一周接一周

点卡片跳到那一周
01

学会提问

AI 说得很自信,不代表它对。

课上

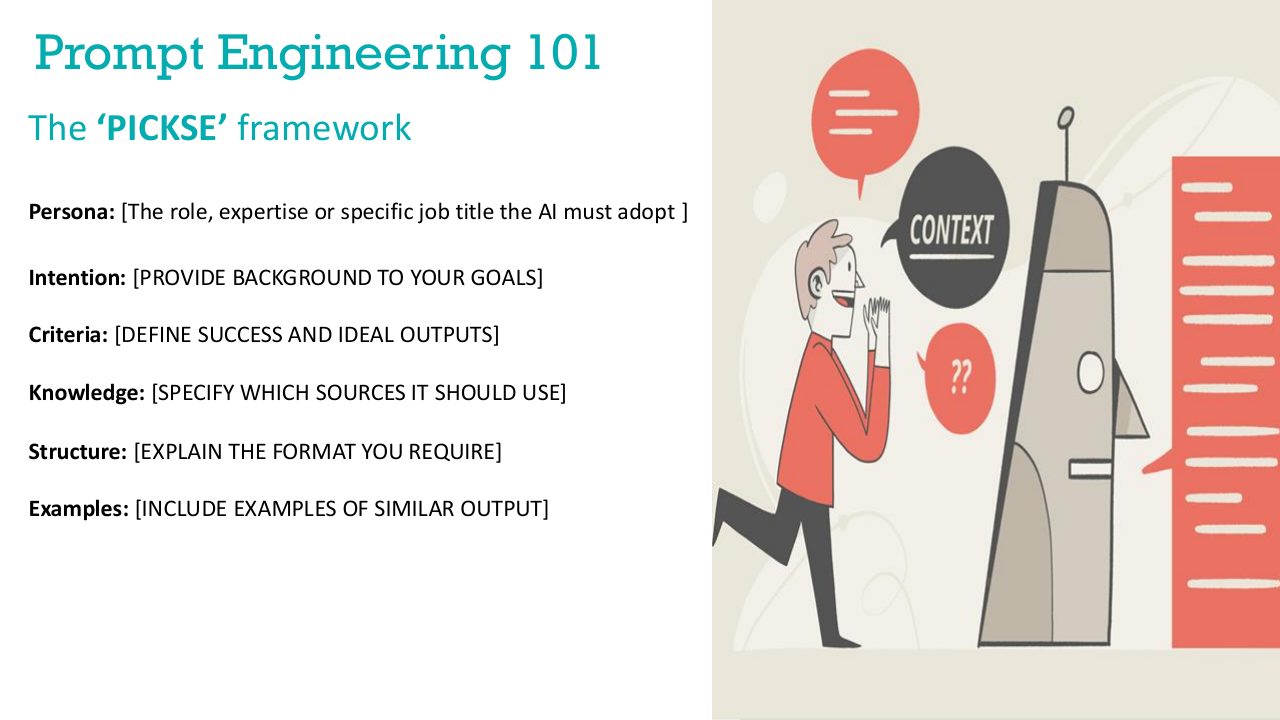
PICKSE 提示词框架,同一个问题问几种 AI,比较回答。

P角色
I意图
C标准
K资料
S结构
E示例
我们

比较了三种模型,每人写下三条用 AI 的原则。

ChatGPT最保守,可靠但平淡
DeepSeek快、懂意图,会出事实错误
Gemini最快、会总结,有时误解意图
白板 Week 1 · 三种模型的比较和分享链接
白板上每人的原则(原文摘一句)
Qilin“Do not trust AI 100 percent, checking and judging the response by critical thinking.”
Ron“The most effective opener is: ‘You are a product manager. Now please…’”
Shenglin“Form your own judgement regarding the content generated by AI.”
Freya“Question the output instead of directly accepting it.”
Lan“Prioritize personal privacy and information security; do not fully disclose information to AI.”
Shuhan“I should think about the problem myself first and form my own ideas.”
→ 交给第 2 周

W2 的伦理提示词按 PICKSE 来写;“不全信 AI”变成了规矩:AI 给的清单都要对照案例核对。

原件
W1 Seminar p.11 · 打开
p.27 · 专家级提示 · 打开
p.30 · 反思四问 · 打开
白板 Week 1 全图
还缺什么
  • 白板没记下“初级 → 中级 → 专家”三步提示的过程,也没有 consulting framework 的结果。
  • 白板上 Nirone 的那段不算我们的成员。
02

先看风险

先自己想,再让 AI 扩充,最后我们自己合并、分类。

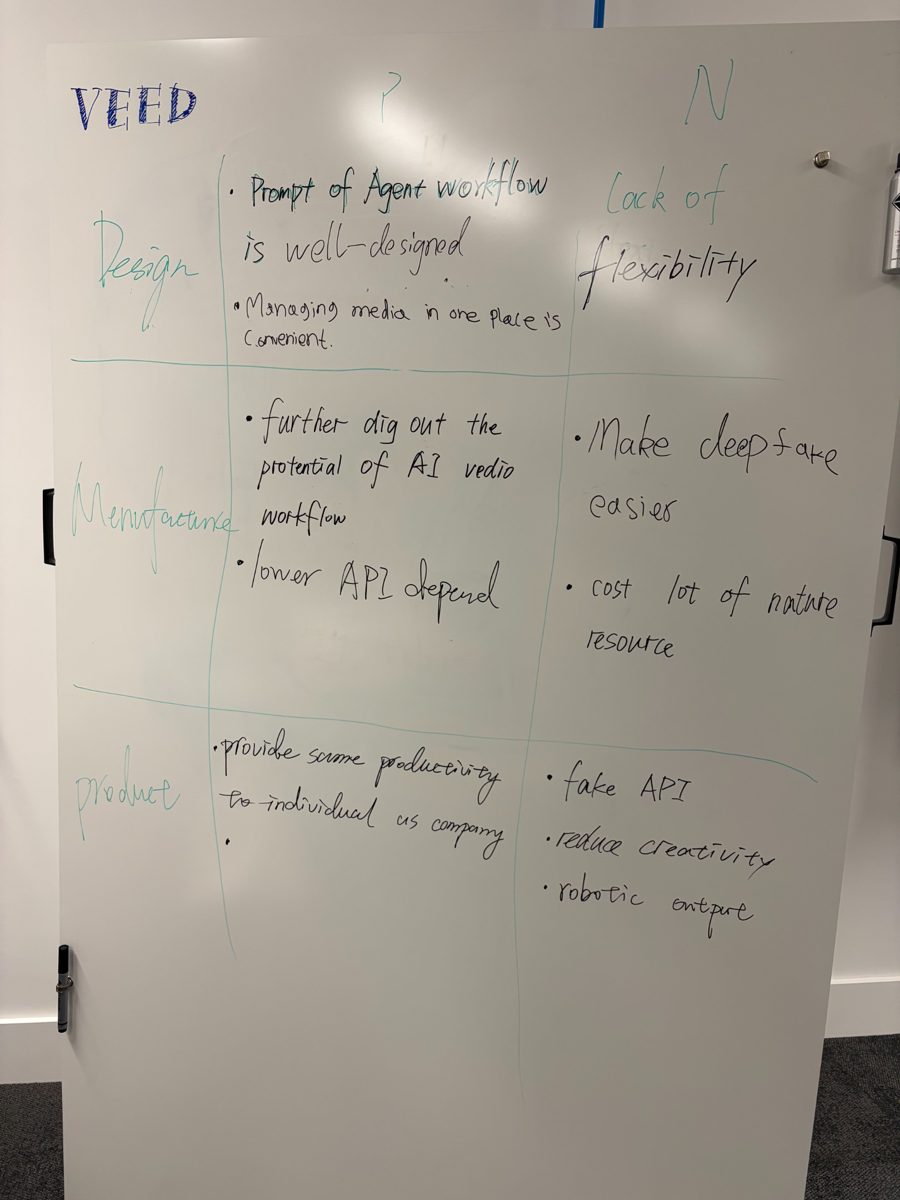
不用电脑的白板:正面 P / 负面 N × Design / Manufacture / Product
课上

伦理在三个地方出问题:Design(模型学什么)、Manufacture(算力、能源)、Product(拿它做什么)。

我们

先手写白板,再让 ChatGPT 和 DeepSeek 各列风险,在群里汇总了 5 份回答。

9 月 29 日,F3 群里互相分享 AI 回答的链接
AI 原话:单列“地缘政治风险”
我们
合并 →
规则

重复的合并;地缘政治推测不单列,跨境数据并入第 1 条;“提到 VEED”不算 Specific 的理由。

结果:10 条风险的分类(● 表示适用)
伦理风险ProdDesignManufSpecificGeneric
1 隐私、声音肖像授权→ 红线 3
2 深度伪造、虚假信息
3 偏见、字幕无障碍
4 版权、训练数据
5 AI 透明度、披露
6 有害内容、审核
7 责任归属不清→ 红线 1
8 工作替代
9 过度依赖、技能退化→ 红线 2
10 增长压过治理

来源:VEED_10项伦理问题分类(表内注明是讨论稿)。红色箭头是它在 W6 变成的红线。

→ 交给第 3 周

同一招:PICKSE 提问 → AI 扩充 → 对照案例删。这张表一直用到 W6。

原件
W2 Lecture p.12 · 打开
W2 Seminar p.16 · 打开
p.17 · 分类任务 · 打开
我们的 PICKSE 伦理提示词
DeepSeek 回答(15 条)
seminar 现场
要注意:白板和记录说法不一致
白板 Week 2 写的是 “ChatGPT and Claude”Prompt Log 和伦理表写的是 ChatGPT + DeepSeek
  • 要以原始对话为准,统一说法。
  • 伦理表还缺一列“这一条怎样改变了设计”(范本 p.11)。
03

找出 VEED 的问题

AI 是工具,先问:这个问题真的适合用 AI 吗?

课上

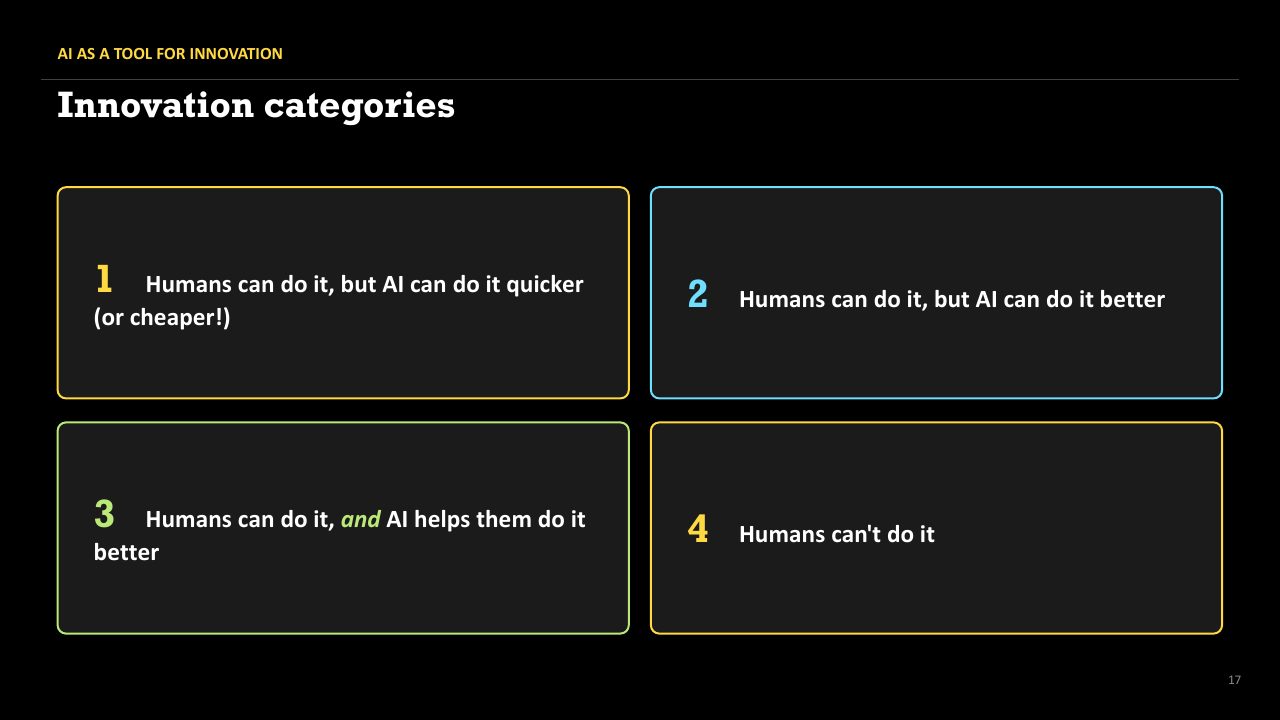
四类 AI 创新,和一张三问的 checklist。

1人能做,AI 更快更便宜
2人能做,AI 做得更好
3人来做,AI 帮人做得更好
4人做不到
我们

读案例列问题 → 用 AI 扩充,案例不支持就删 → 每个问题打 High / Medium / Low。

产出
AI 成本:$1/分钟收购 SpiritMe团队小内部抵触 AI专注 vs 大而全
W3 Seminar p.16 · Stage 4:给 AI 适用性打分 · 打开

这一周的原件最少

白板上只写了做法,问题表和 H / M / L 打分结果都没留下。Stage 1 的行业问题表和 AI readiness 作业也没有。谁存过,找回来贴上。

→ 交给第 4 周

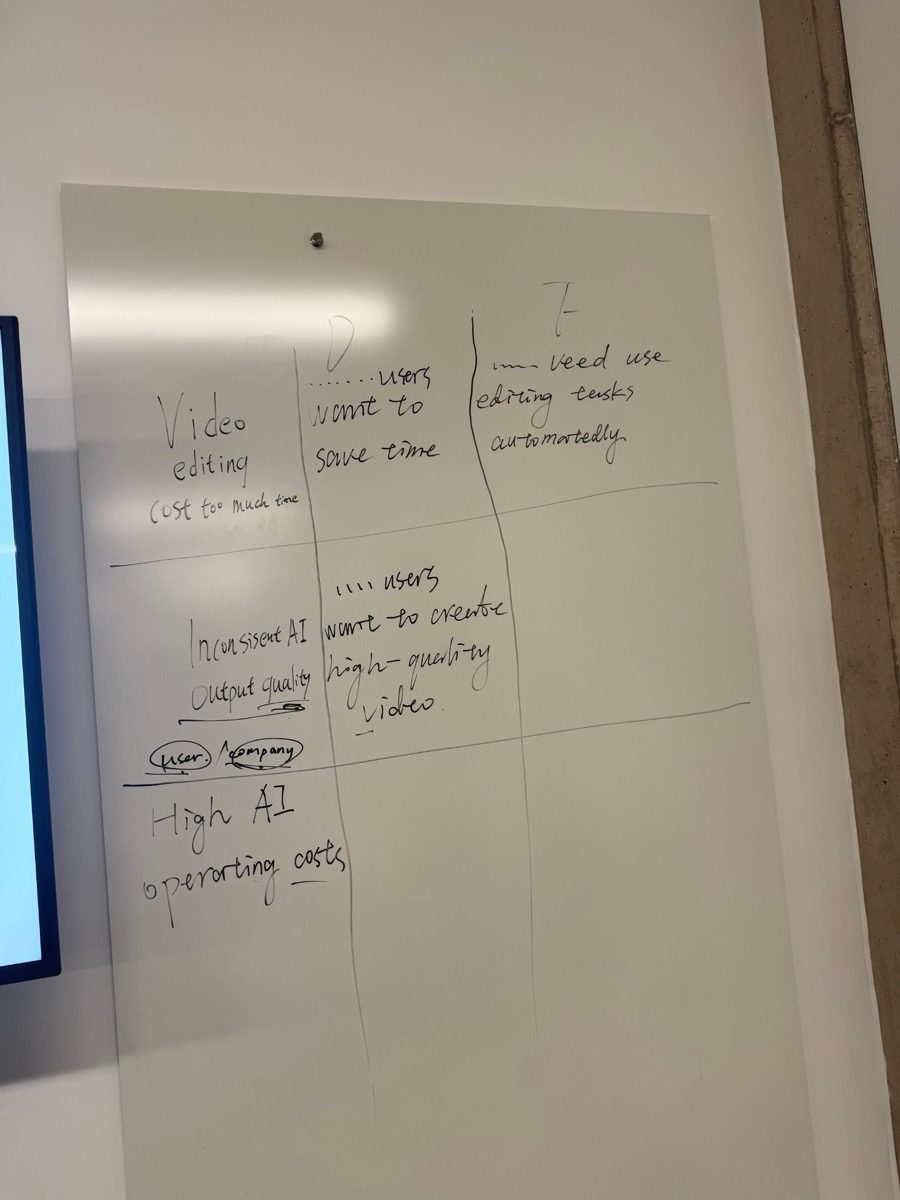
W4 第一步:“从第 3 周的问题里选三个”。我们选了:剪辑太耗时、AI 质量不稳、AI 成本太高。

原件
W3 Lecture p.17 · 打开
p.29 · checklist · 打开
Seminar p.14 · 案例不支持就删 · 打开
p.19 · readiness 作业 · 打开
白板 Week 3
04

先写“我们以为”,再去问

课件原话:好的用户调研会 “INVALIDATE your assumptions”。

课上手写:三个假设 × D / F
课上

用 DFV 写假设(用户要不要 / 做不做得出 / 值不值钱);按 Mom Test 访谈:只问过去发生的具体事。

我们

三个假设各找了外部证据(Wistia、Descript、NIST、案例),写出“还要查清什么”,再用课程 Custom GPT 访谈 Sabba(3 题)和 Maya(5 题)。

产出
DFV 证据表8 道 Mom Test 问题访谈稿
每个假设 → 问了哪题 → 结果
假设访谈问题结果
① 剪辑太耗时
→
Maya Q1:上一个视频从头到尾怎么做的
→
推翻:初剪约 1 小时
Q1 里冒出的线索
→
Maya Q2、Q3:追问反馈和返工
→
新问题:反馈分散、审批慢
② AI 质量不稳
→
Maya Q4:最近一次字幕出错
→
部分成立,但排在审批后面
③ AI 成本高
→
Sabba Q2:成本怎样影响过决定
→
成立:收购 SpiritMe
访谈原文(黄色是我们引用的句子)
Maya Q1 · 初剪大约一小时打开访谈稿 p.5
Maya Q3 · 她自己说这些数字是估计打开 p.7
→ 交给第 5 周

原话和数字成了 persona 和问题陈述的材料。

原件
W4 Seminar p.11 · 打开
W4 Lecture p.31 · Mom Test · 打开
p.34 · 推翻假设 · 打开
课上第二块板
白板 · DFV 证据
白板 · 访谈问题
还缺什么
  • 白板上 Problem 1 的 Desirability 证据格是空的,只写了来源。
  • 没标“风险最大的假设”(其实就是 A1)。
  • Market Opportunity Sizing 没做。
  • 课上那次 CEO 访谈丢了,用 Claude 重建过一次,已弃用;现在的访谈稿是用 Custom GPT 重做的。旧版里 Maya 答了 6 题,不要引用。
!

转折:剪辑不慢,审批慢

这一段是 deck 里最有分量的 Decision trail。

一个视频项目里的时间(Maya Q3 的例子,她自己的估计)
剪辑
≈ 1 h
额外返工
3–4 h
01h2h3h4h
再加上 +1 个工作日 的等待:“one working day … closer to two”
最近 5–6 个项目里,有 3–4 个受影响
Maya Q2打开 p.6
Maya Q3打开 p.7
Maya Q5 · 她把审批排第一打开 p.9
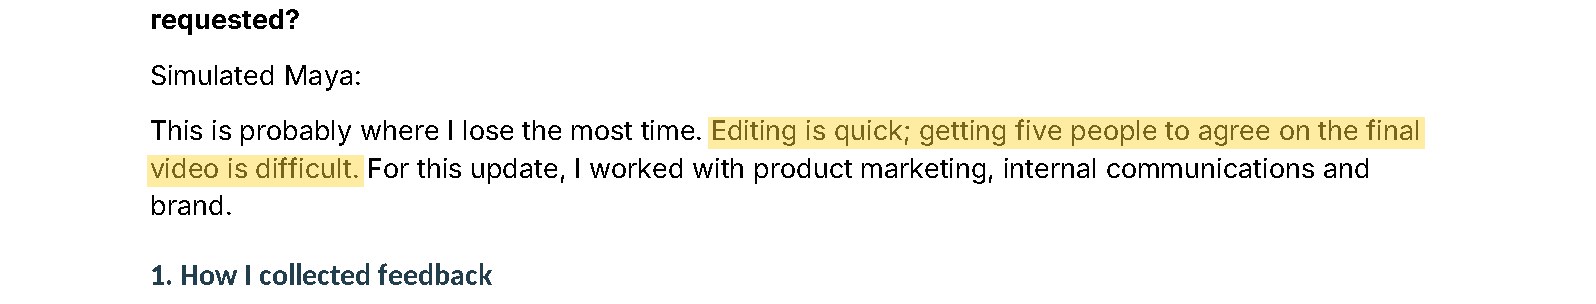
OBSERVE初剪 1 小时;返工 3–4 小时
INTERPRET时间耗在反馈和审批,不在剪辑
DECIDE组内有分歧;每人写一版,再合并
CHANGE核心问题改成审批;剪辑降为次要
TEST NEXT真实用户也这样吗?
证据有多强?

只有一个 AI 角色,数字都是估计。要主动说出来,并说清下一步去找真实用户验证。

05

定义问题

CEO 帮我们看清机会和约束,用户帮我们定义问题。

课上

persona 要有证据;问题陈述要 specific、可衡量;Innovation Goal 公式:Harness AI to [purpose] for [persona] so they can [benefit]。

我们

做了两张 persona,写出五格问题陈述,再合并成一段。

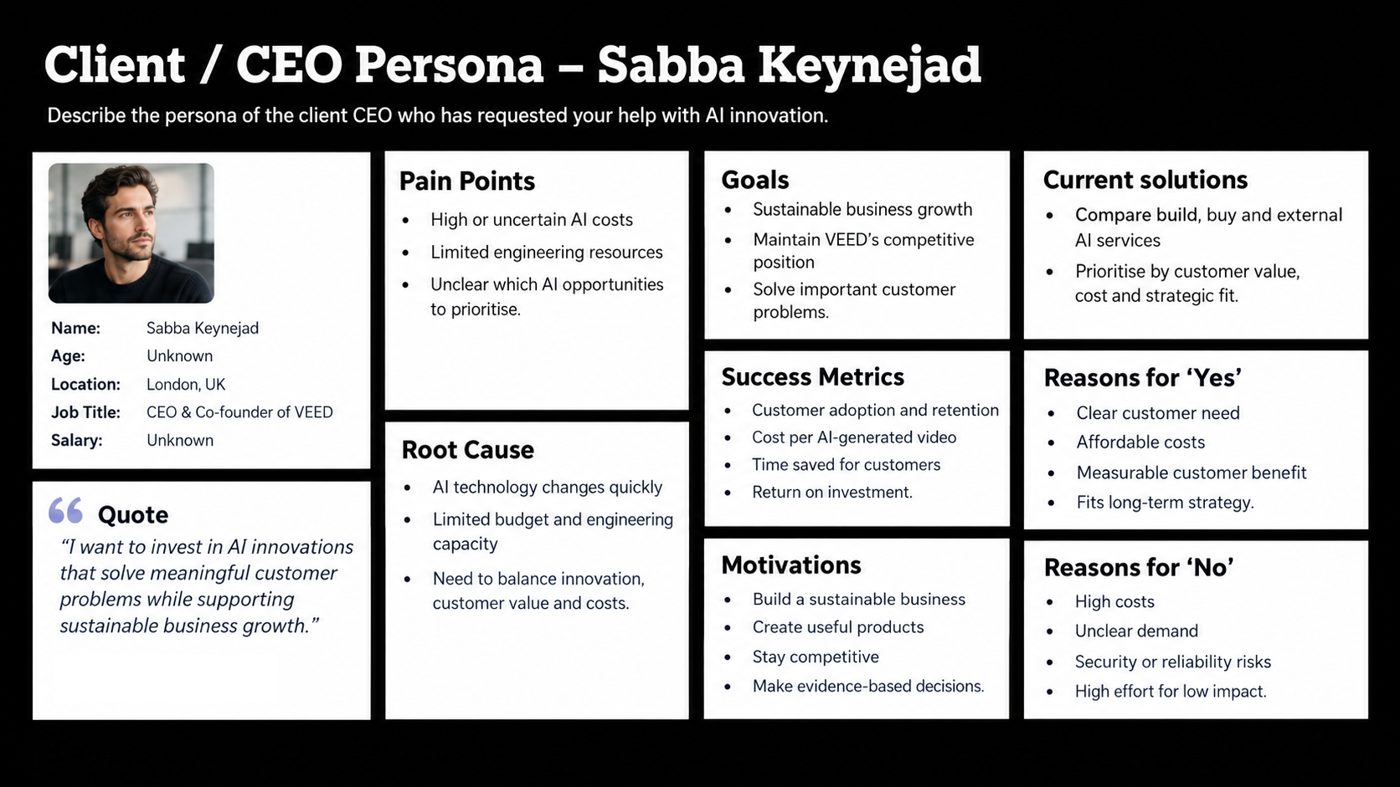
客户:Sabba Keynejad(CEO)
最终用户:Maya Chen(Video Strategist)
问题陈述(白板原文的中文概括)
WHO用 VEED 做商务视频、要多方审批的营销人员
WHAT又快又好做出视频,发布前拿到批准
BARRIERS反馈散在 Slack 和邮件;意见冲突;剪完还要改
CAUSE没有统一协调的审核和审批流程
IMPACT返工、延误:60–70% 的项目受影响,+3–4 h,+1 天
→ 交给第 6 周

三个障碍逐个判断:AI 帮得上哪个?答案决定了 Goal 用什么动词。

原件
白板 Week 5 · 问题陈述
W5 Seminar p.5 · 聚类 · 打开
p.10 · 问题陈述 · 打开
W5 Lecture p.13 · 打开
p.22 · Goal 公式 · 打开
W4 Lecture p.16 · 多一格 Constraints · 打开
要注意
  • 上面两张 persona 图里的 Quote 是概括的话,在访谈稿里找不到原文;Sabba 那张的 London 也没有出处。做 deck 时用 W6 版:逐字原话,不知道的写 “?”。
  • 课上要求先聚类再做 persona,我们的聚类是 W6 才补的,讲的时候照实说。
  • 问题陈述可以补一格 Constraints,用 W2 伦理表来填。
06

定目标、找方案

没有课。目标是带着问题陈述、Goal、需求 → 方案进入 W7。

AI 起草 · 团队还没商定
先判断:三个障碍里,AI 帮得上哪个?
反馈分散 → 适合汇总、归类评论是 AI 的拿手事
意见冲突 → 一部分能发现矛盾,不该替人选
审批不清 → 不是 AI 的事谁来批,是流程和人的问题
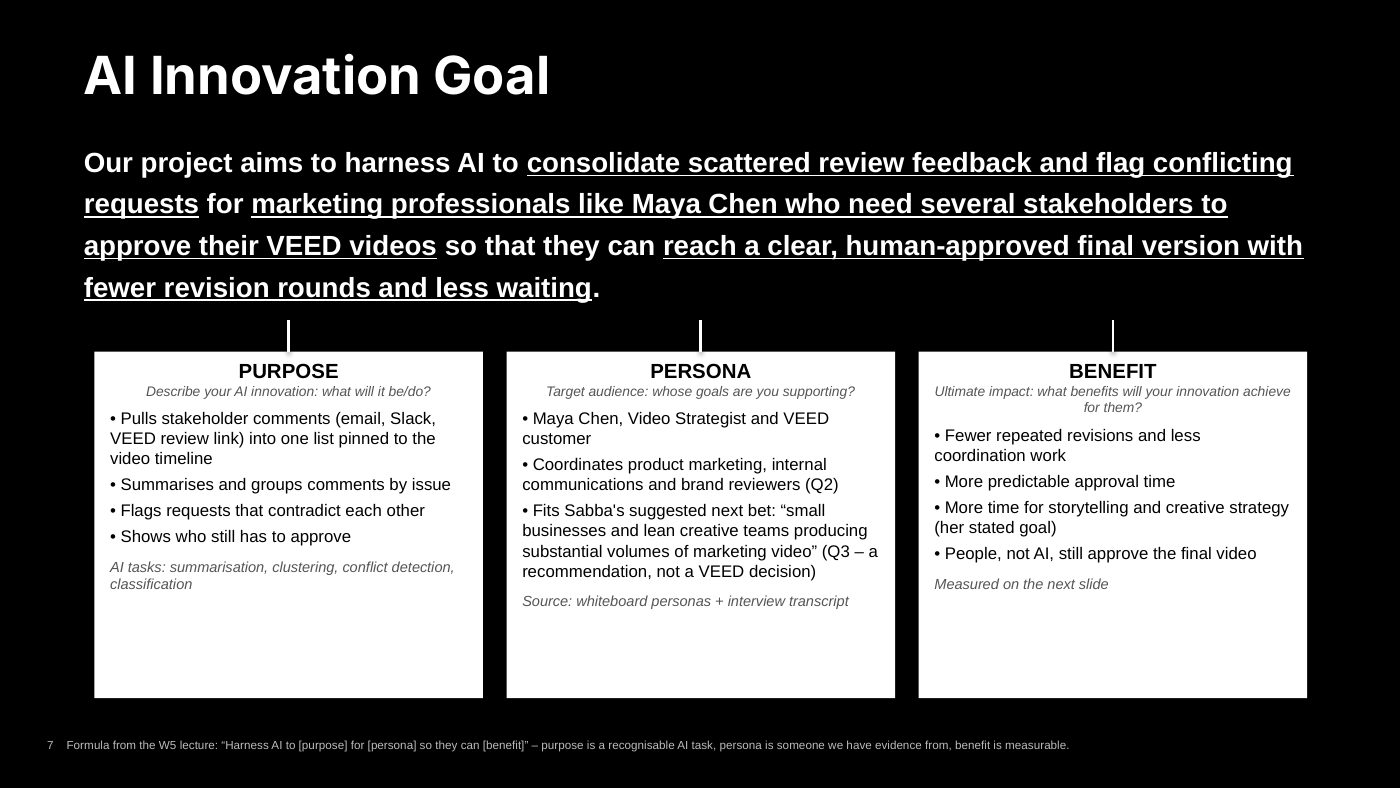
所以 Goal 的动词是“汇总”和“标出”

Harness AI to consolidate scattered review feedback and flag conflicting requests for marketing professionals like Maya Chen … so that they can reach a clear, human-approved final version with fewer revision rounds and less waiting. AI 做什么为谁带来什么

5 个需求 → 5 个功能(按优先级)
1TOP

Approval Tracker

谁来批、何时截止、每版的状态

2URGENT

Feedback Inbox

邮件和 Slack 评论汇总到同一版的时间线上

3URGENT

Conflict Flag

把相反的要求并排标出,人来决定

4NEXT

Version Diff

标出针对旧版本的评论

5SECONDARY

Brand Glossary

术语表,字幕不再重复改

三条红线(来自 W2 伦理表)
0 次 AI 批准AI 不批准视频,也不替人选冲突的意见← 伦理表 #7 责任归属
无出处不摘要每条摘要都链接原评论和作者← #9 过度依赖、幻觉
素材不外流不用来训练,未经同意不发给第三方 AI← #1 隐私
W6 slide 8 · 指标:受影响项目 ≤35%,返工 ≤2 h,等待 0 天(都是提议) · 打开
W6 notes:目标数字是草稿提出的,团队还没商定打开
核对清单还没打勾打开
值得主动讲的一点

排第一的 Approval Tracker 几乎不用 AI。这正是 W3 checklist 第二问:“AI 是最好的工具吗?”测试时要和 Maya 现在的手工办法比。

→ 交给第 7 周

先画功能 1–3 的低保真原型,再拿回去给两个角色测试。

原件 · W6 slides
slide 2 · 聚类 · 打开
slide 6 · 问题陈述 · 打开
slide 7 · Goal · 打开
slide 9 · 需求 → 功能 · 打开
slide 10 · 可行性和风险 · 打开
slide 11 · 不做什么 · 打开

待办

按紧急程度排
待商定

Goal 的措辞、目标数字、三条红线、PROPOSED 的放弃方案

影响 deck 的 Goal 页、Decision trail 页
要改

把 10 月 22 日的 AI 使用记进 Prompt Log(W6 的两轮起草,加上这个网页)

Prompt Log 只记到 10 月 20 日
要改

统一 W2 用的是哪两种 AI(白板写 Claude,log 写 DeepSeek)

影响伦理页、AI 使用页
要改

白板 persona 图改用原话,没有出处的写 “?”

范本 p.8 正是“没有来源”的反例
缺

W3 问题表和打分、Stage 1、AI readiness 作业

影响 AI landscape、机会地图页
缺

Problem 1 的 D 证据;风险最大的假设;Market Sizing

影响 Assumptions 页
缺

伦理表“怎样改变了设计”一列;问题陈述的 Constraints

影响伦理页、问题陈述页
缺

真实用户验证:现在所有用户证据都来自一个 AI 角色

影响 User discovery、Testing 页

老师可能会问

点开看方向,不是标准答案

规定:028 brief 禁止用 AI 准备答辩稿。这里只给方向和证据,每个人用自己的话写英文关键词卡。练习时每个回答追问三次:Why? → How do you know? → What would change your mind?

过程为什么从“剪辑速度”转到“审批”?这不只是一个 AI 角色的看法吗?Isn't that just one persona's view?
方向按 Observe → Decide → Test next 讲;先承认只有一个 AI 角色、数字是估计;说出下一步怎么验证
证据转折、Maya Q1–Q3、Q5
别说“已经确定了”

如果真实用户都说剪辑最慢,方案里哪些还能留下?

过程你们的访谈问题符合 Mom Test 吗?有没有引导性的?Were any questions leading?
方向好的地方:Q1 问具体经历,Q2、Q3 是顺着回答追问的。主动说弱点:Maya Q4 预设了字幕会出错,Q5 是排序题
证据访谈稿、W4 Lecture p.31
别说“完全按 Mom Test 做的”

去掉 Q4、Q5,结论会变吗?

过程为什么以 Maya 为中心,而不是 CEO Sabba?Why the end user, not the client?
方向CEO 给出机会和约束,用户定义问题;Sabba 说客户体验比拥有技术更重要(Q1)
证据W5 Seminar p.9、Sabba Q1、Q3
别说“因为 Maya 的问题问得多”

大公司的 Maya 和 Sabba 看好的“小团队”是同一类人吗?

过程≤35%、≤2 小时这些目标从哪来?可信吗?Where do your targets come from?
方向基线是 Maya 的估计;“减半”是她自己的预测;目标是 AI 起草的,团队还要商定
证据W6 slide 8 脚注、Maya Q3
别说把目标说成已证实的效果

只降到 50% 算失败吗?

AI 使用为什么选 ChatGPT、DeepSeek、Claude,不用别的?Why these tools?
方向W1 比较发现各有短板,所以用两种以上交叉核对;课程要求用两种 LLM;每个工具负责什么要说清楚
证据白板 W1、W2 Seminar p.16、Prompt Log
别说“大家都用”

如果只能用一个工具,会损失什么?

AI 使用AI 帮你们列清单时,错在哪?怎么发现的?Where did the AI get it wrong?
方向案例里找不到依据就删;地缘政治风险不单列;“提到 VEED”不算 Specific 的理由
证据W2 的合并规则、伦理表
别说“AI 给的都挺好”

有哪一条是我们先信了、后来发现站不住的?

AI 使用我怎么知道这是你们的想法,不是 AI 的?Your thinking or the AI's?
方向坦白说 W6 是 AI 起草的,指向 log 里“接受、修改、拒绝”的记录;讲白板上的讨论和那次分歧
证据课堂照片、W6 notes 第 9 节
别说“AI 只是润色”

W6 里哪个判断,你能完全用自己的话讲出理由?

AI 使用用 AI 角色做访谈,有什么局限?Limits of AI personas?
方向回答流畅不等于真实行为;CEO 访谈丢过、重建过又放弃了,现在访谈都当场存档;下一步找真实用户
证据访谈稿、W5 Lecture p.9
别说把 Maya 当成真人引用

课程角色会不会本来就被设定成“指向审批”?

伦理对你们的方案,哪个伦理风险最重要?Which ethical risk matters most?
方向要具体:读取 Slack 和邮件涉及隐私;摘要可能出错;人可能不再看原文。每个风险都对应一条设计措施
证据伦理表 #1、#7、#9 → 三条红线
别说泛泛地说“隐私和偏见”

Approval Tracker 会不会变成盯人的工具?

伦理伦理分析真的影响了设计,还是只做了一张表?Did ethics change your design?
方向讲伦理表 → 红线这条线;还影响了放弃哪些方案(给审核人打分、AI 选意见)
证据W6 slide 11
别说“伦理是第 2 周的作业”

10 条里哪条我们完全没处理?为什么可以不处理?

价值排第一的功能几乎不用 AI,这还算 AI 创新吗?Is AI the right tool?
方向坦然承认,用 W3 checklist 第二问回答;AI 真正用在汇总和冲突检测;先做便宜的部分也符合 Sabba 对成本的顾虑
证据W3 Lecture p.29、W6 slide 10
别说“每个功能都需要 AI”

这属于四类 AI 创新的哪一类?(团队还没定)

价值VEED 为什么要做这个?AI 成本怎么办?Why would VEED invest?
方向客户体验比拥有技术重要(Sabba Q1);摘要是常规功能,可以先用外部 API(Q2);做在编辑器里,符合专注视频的方向
证据Sabba Q1–Q3、案例 p.2
别说“用户肯定愿意多付钱”

如果每个视频的 AI 成本翻倍,Sabba 还会同意吗?

协作组里意见不一致时怎么处理?A time you disagreed.
方向讲选核心问题那次分歧:每人写一版,再合并;最后是证据说服了大家,剪辑速度作为次要问题保留下来
证据W6 notes 第 1 节
别说“从没分歧”

那次你最开始站哪边?

反思证据里最弱的是什么?如果重来会怎么做?Weakest evidence? What would you change?
方向只有一个 AI 角色;W3 的打分没留下;访谈丢过。重来的话:更早找真实用户,当场存档
证据待办
别说“时间管理可以更好”

老师最可能自己发现的弱点是哪个?要抢先说。

个人你个人做了什么,影响了哪个决定?What did you personally do?
方向挑 2–3 件事,按“做了什么 → 判断 → 改变了什么 → 证据”讲,用 I。职业自我认知分数最重:评分矩阵写 10/25,个人 brief 写 15%,两份不一致,可以问老师
证据白板上署名的段落、Prompt Log
别说“我们什么都一起做”

把你从团队里拿掉,会少什么?

文件

点开就是 PDF
我们的作业
课程要求
课件